核心不只是更大,而是把一次任务做得更便宜
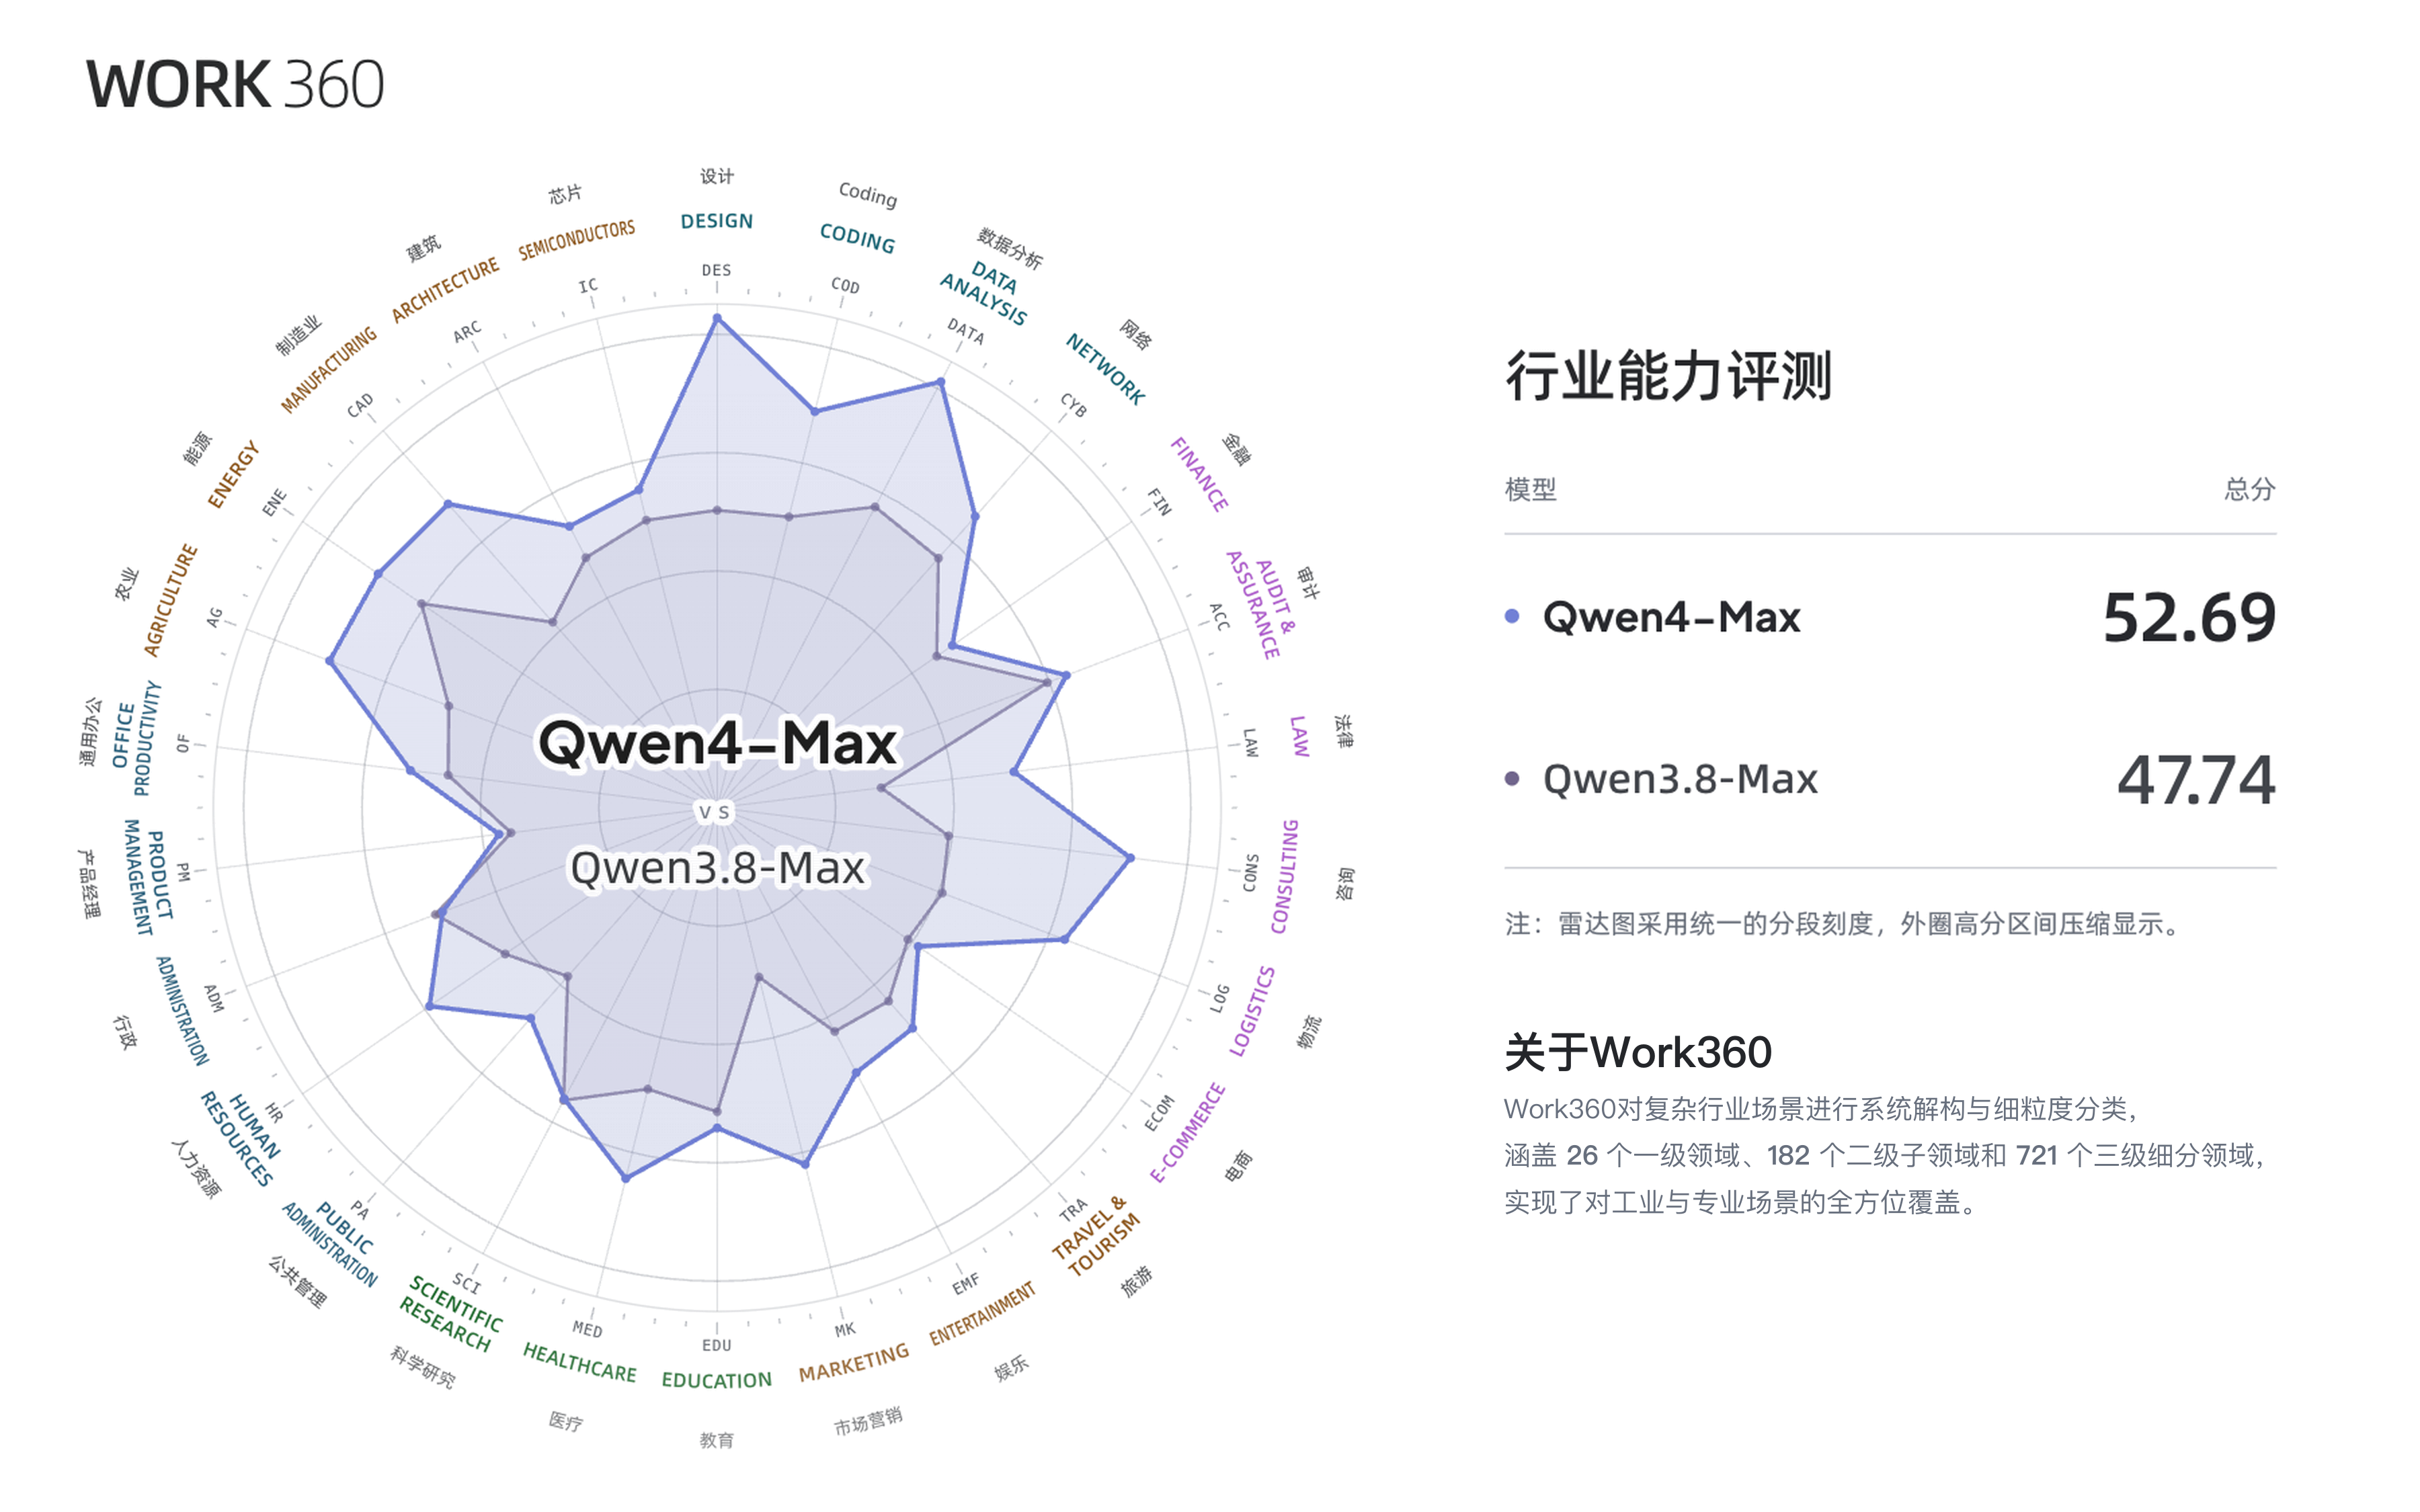
阿里发布的Qwen4-Max,最值得关注的指标并非2.4T总参数,而是完成同等级专业任务所需的时间和费用。它在Terminal-Bench 4.0中,将每次尝试的平均Token用量由289K降至151K,评测得分则由38.9升至48.5;在相同思考档位下,单任务平均成本进一步下降58%。这意味着模型竞争正在从“谁的参数更多、榜单更高”,转向“谁能以可接受成本把任务真正做完”。
这一变化对API调用方尤其重要。大模型项目最常见的失败并非演示效果差,而是长上下文、工具调用和多轮修正不断累积Token,最终让成本与响应时间失去控制。Qwen4-Max试图证明,效率优化可以与能力提升同时发生,而不必依靠牺牲思考深度来换取低价。
| 指标 | Qwen3.8-Max | Qwen4-Max | 变化 |
|---|---|---|---|
| 单次尝试平均Token用量 | 289K | 151K | 减少近50% |
| Terminal-Bench 4.0得分 | 38.9 | 48.5 | 提升近25% |
| 每Token激活参数 | — | 71B | 较上代减少25% |
| 单任务平均成本 | — | — | 下降58% |
效率来自架构、推理与缓存的协同
Qwen4-Max采用Qwen稀疏注意力,也就是QSA,并结合MoE架构:模型总规模达到2.4T,但处理每个Token时只激活71B参数。稀疏化的价值在于避免每个请求都动用全部参数,同时让不同专家承担代码、分析、视觉或规划等不同能力。与单纯压缩模型不同,这种路线保留了大模型的容量上限,却把日常推理成本控制在更小范围。
此次提升还来自训练与推理策略的配套优化。官方给出的案例显示,模型可先交付可用版本,再根据反馈连续迭代,形成所谓Live Delivery机制。在物理课堂网站任务中,Qwen4-Max共给出14次可用版本,逐步扩展为包含3D动画、交互实验和原理说明的成品。它还能够规划、调用工具、验证结果并继续修正,说明评估对象已经从单轮问答扩展到了完整工作流。
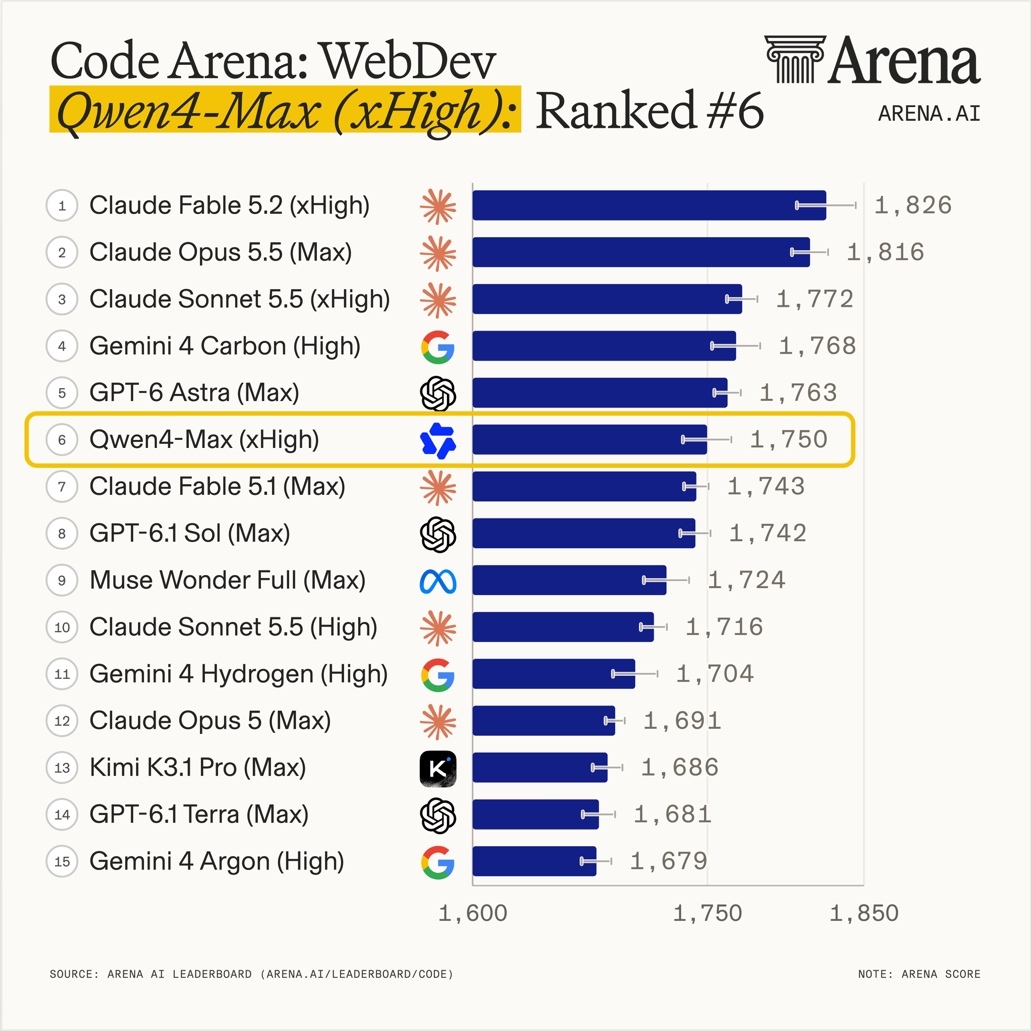
不过,榜单成绩不能直接等同于生产稳定性。CodeArena前端开发全球第六、ALE得分46.7、JobBench得分68.5,能够反映特定测试下的能力位置,但不能单独证明所有代码库、语言和业务约束都能得到同等结果。特别是金融、法律、汽车制造等场景,还需评估幻觉率、工具调用成功率、数据权限隔离和结果可追溯性。
普通用户与开发者会感受到什么
对普通用户而言,更低单任务成本最终可能表现为更长的免费额度、更快的连续修改和更少因预算中断的复杂任务。千问AI平台已提供API服务,缓存命中价格低至每百万Tokens 0.5元;用户也可通过阿里Token Plan、千问办公、Qoder和千问APP使用相关能力。价格下降并不会自动转化为低价格,但会扩大高频、交互式场景的可行范围。
对开发者的影响更为直接:智能体应按“每个完成的任务”设计成本模型,而不能只比较每百万Token的标价。一个需要数十次工具调用的流程,即使单价便宜,也可能因循环重试、冗长上下文和无效规划产生高额费用。Qwen4-Max减少Token消耗,实质上降低了长链路任务因上下文膨胀而失控的概率。
- 搭建智能体时,应设置最大调用轮数、预算上限和停止条件。
- 代码任务应优先使用小步生成、自动测试与增量修改,避免一次提交超长需求。
- 对价格敏感的生产流量,应分别测算缓存命中、未命中及输出Token成本。
- 企业上线前应使用自有任务集复测,不能只依赖公开榜单。
落地建议:先选高价值长任务验证
Qwen4-Max现阶段更适合验证两类场景:一类是步骤多、上下文长、原本需要人工反复检查的任务;另一类是输出能够被程序或专业工具验证的任务,例如代码测试、数据分析、报告生成和工艺规划。它们更容易体现Token缩减与工具编排带来的收益。
团队可以选取当前成本最高的一个流程,建立上线前基线,同时记录完成率、平均Token数、工具调用次数、人工接管率和单任务费用。上线后保留旧模型作为对照组,分别在相同任务与思考档位下测试,避免把模型更新、提示词调整和缓存优惠混为一谈。
如果结果稳定,再逐步把审批节点、数据访问控制和失败回退接入系统。中小型Qwen4模型后续陆续开源,也值得持续关注:对于数据不能出域、调用量较大或需要私有部署的团队,较小模型可能比旗舰模型更适合承担分类、抽取、路由和初稿生成,Qwen4-Max则留给复杂推理与最终校验。由此形成的分层架构,往往比让一个超大模型处理所有步骤更经济。
© 版权声明
文章版权归作者所有,未经允许请勿转载。